pgvector spiegato semplice, parte 1: come far capire il significato a un database
Un database che trova i documenti anche quando non contengono le parole che hai scritto? Con pgvector si può. Prima puntata: cosa sono gli embedding e perché cambiano la ricerca.
Un problema che conosci già
Immagina un archivio di contratti. In uno c'è scritto: «Il conduttore può esercitare il diritto di recesso con preavviso di sei mesi». Tu cerchi: «come disdire l'affitto».
Per un essere umano la risposta è ovvia: è proprio quel documento. Per una ricerca normale, no. Nel testo non compaiono né «disdire» né «affitto». Risultato: zero risultati, e la sensazione che il computer non capisca niente.
Come cercano i computer di solito
La ricerca di sempre confronta parole. Se scrivi «affitto», cerca documenti che contengono «affitto». Le versioni più evolute sanno che «affitti» e «affittare» sono parenti, e qualcuna conosce anche dei sinonimi, ma sempre di parole si tratta.
Va benissimo per cose precise: un cognome, il numero di una fattura, un codice. Ma è cieca davanti al significato. E noi, quando cerchiamo, di solito non ricordiamo le parole esatte: ricordiamo l'idea.
L'idea geniale: trasformare il significato in numeri
Da qualche anno esistono modelli di intelligenza artificiale capaci di leggere un testo e restituire una lista di numeri che ne rappresenta il senso. Questa lista si chiama embedding, o, più semplicemente, vettore.
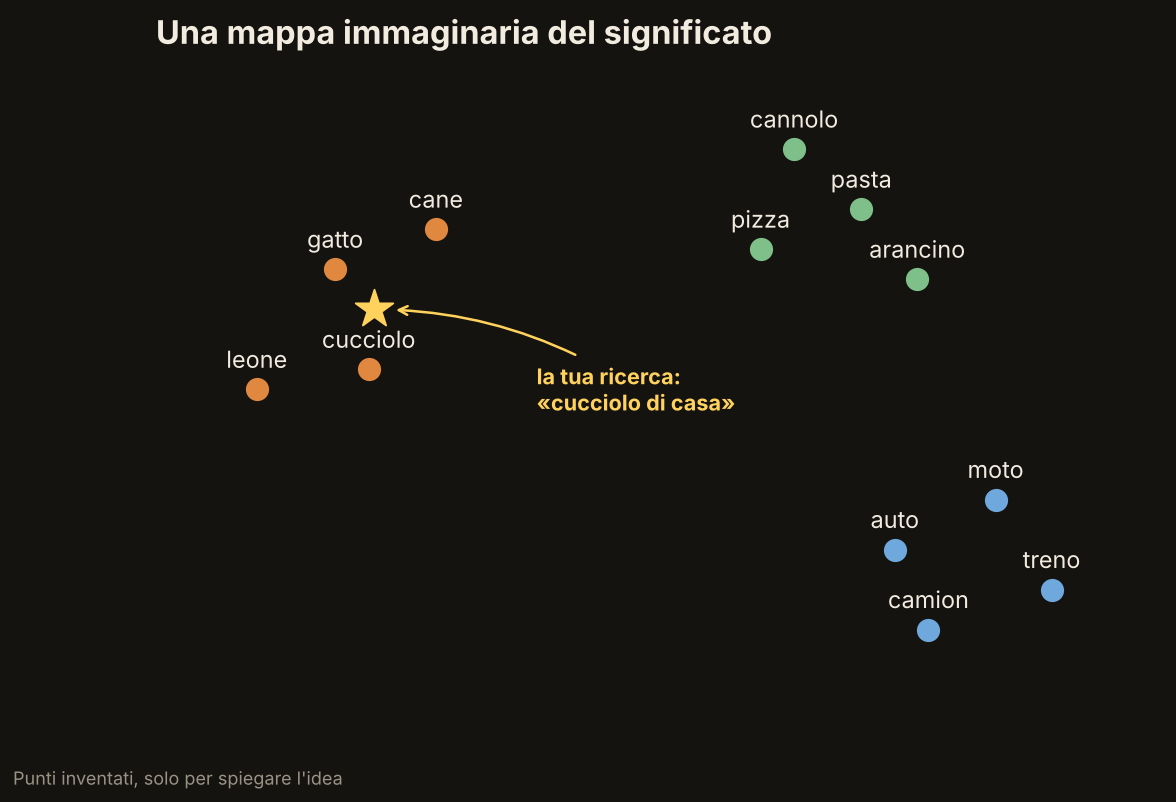
Il modo più facile per capirlo è pensare a una mappa. Ogni frase, ogni parola, ogni documento diventa un punto sulla mappa. E la regola è una sola: cose che significano cose simili finiscono vicine.
«Gatto», «cane» e «cucciolo» stanno nello stesso quartiere. «Auto», «moto» e «camion» in un altro. «Pizza», «pasta» e «cannolo» in un terzo. E la tua ricerca «cucciolo di casa», anche se non contiene la parola «cane», atterra proprio nel quartiere degli animali.
Una precisazione importante: i modelli veri non usano una mappa piatta con due coordinate, ma centinaia o migliaia di numeri per ogni testo. È come avere una mappa con tante dimensioni, impossibile da disegnare, ma l'idea è identica: la vicinanza vuol dire somiglianza di significato.
Cercare diventa misurare distanze
A questo punto cercare è sorprendentemente semplice:
1. Il testo che cerchi diventa anch'esso un punto sulla mappa.
2. Il database guarda quali documenti sono più vicini a quel punto.
3. Ti mostra quelli, in ordine di vicinanza.
Per tornare ai contratti: «come disdire l'affitto» e «diritto di recesso con preavviso di sei mesi» finiscono vicinissimi, perché parlano della stessa cosa, anche se non hanno una parola in comune.
Dove entra pgvector
pgvector è un'estensione gratuita e open source di PostgreSQL, uno dei database più usati al mondo. Aggiunge due cose:
- un nuovo tipo di colonna, per salvare i vettori accanto agli altri dati;
- gli strumenti per trovare i più vicini a un punto, e gli indici per farlo in fretta anche con tanti documenti.
Il vantaggio è pratico: non serve un database separato, né un servizio in più da gestire. I vettori vivono nello stesso database dove hai già utenti, documenti e permessi. E una sola domanda può dire, per esempio: «trovami i documenti più simili a questo, ma solo quelli di questo cliente».
Che cosa ci puoi fare
- Ricerca per significato nei documenti di un'azienda o di uno studio.
- «Documenti simili a questo», come i suggerimenti di un sito di articoli.
- Assistenti che rispondono sui tuoi file: prima trovano i passaggi più adatti alla domanda, poi li passano a un modello di linguaggio che scrive la risposta.
- Individuare duplicati o quasi-duplicati in un archivio.
I limiti, detti onestamente
- Dipende dal modello. I vettori li produce un modello di IA: se lo cambi, vanno rigenerati tutti.
- Non sostituisce la ricerca per parole. Per un numero di fattura o un cognome preciso, la ricerca classica resta migliore. Le due cose, insieme, funzionano meglio che da sole: ne parleremo in una delle prossime puntate.
- «Simile» non vuol dire «vero». Trova ciò che somiglia alla domanda, non garantisce che sia la risposta giusta.
Dove l'ho usato io
La ricerca per significato con pgvector è uno dei progetti guidati del mio libro Costruire un sistema documentale: un sistema di gestione documentale costruito capitolo per capitolo con Django 6.1, HTMX e pgvector. Se vuoi vedere come si fa dall'inizio alla fine, trovi la scheda qui: Building a Document Management System. Il libro è in inglese.
Prossima puntata
Nella seconda parte mettiamo le mani sul codice: PostgreSQL con Docker, l'estensione pgvector e il primo campo vettoriale in un progetto Django. Passo dopo passo, senza dare niente per scontato.