DeepSeek V4.1 Flash questo sconosciuto
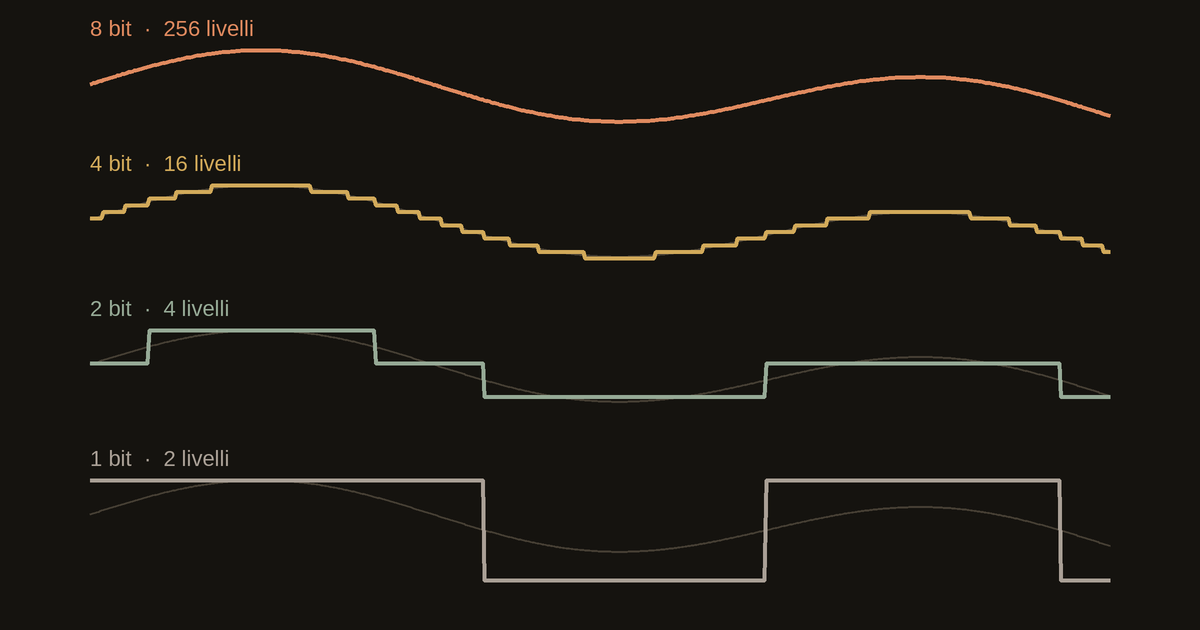
La quantizzazione è il processo che comprime i pesi di un modello per ridurne l'ingombro, e la scelta tra 8 bit e 1 bit è un classico compromesso tra qualità e accessibilità hardware. Per DeepSeek V4.1 Flash, la differenza è sostanziale e va oltre il semplice risparmio di spazio.
Ecco un'analisi dettagliata dei tre aspetti che hai sollevato.
📉 Cosa si perde (e si guadagna) passando da 8 a 1 bit
La perdita di qualità non è lineare: si passa da una compressione quasi impercettibile a un degrado significativo, ma con un guadagno enorme in termini di requisiti hardware.
Quantizzazione a 8 bit (Q8)
- Qualità: È considerata quasi "lossless" (senza perdita). La rappresentazione a 8 bit è in grado di catturare fedelmente sia valori piccoli che grandi, gestendo bene i "pesi anomali" e gli strati del modello più sensibili alla precisione. L'output è tipicamente indistinguibile da quello del modello originale a piena precisione (FP16). L'aumento di perplessità (un indicatore di errore) è solitamente inferiore all'1%.
- Cosa si guadagna: La massima qualità possibile al di fuori del modello originale, ma con un ingombro su disco che per DeepSeek V4.1 Flash è di circa 508 GB.
Quantizzazione a 1 bit (Q1)
- Qualità: Il degrado è netto. La precisione a 1 bit è intrinsecamente limitata e porta a una perdita sostanziale di capacità di ragionamento e accuratezza. In test su altri modelli, l'accuratezza può crollare drasticamente (ad esempio, dal'84% al 48% su compiti specifici). Tuttavia, per DeepSeek V4.1 Flash, le versioni a 1 bit più avanzate (come
UD-IQ1_M) riescono a mantenere un accordo top-1 dell'88,2% con il modello originale, un risultato notevole per una compressione così estrema. - Cosa si guadagna: Un modello che, seppur "annacquato" nelle capacità, diventa estremamente accessibile. L'ingombro scende a circa 250 GB, permettendo di eseguirlo su hardware consumer.
In sintesi, con 1 bit perdi la sottigliezza e la precisione del modello originale in cambio della possibilità di eseguirlo. Con 8 bit, paghi in spazio su disco per avere una qualità praticamente identica all'originale.
💻 L'hardware necessario per caricare il modello
I requisiti hardware variano enormemente in base alla quantizzazione scelta. La tabella seguente riassume la memoria minima (RAM + VRAM) necessaria per le diverse versioni di DeepSeek V4.1 Flash, secondo la guida di Unsloth.
Quantizzazione
Memoria minima richiesta (RAM + VRAM) |
- | 1-bit | 128 – 145 GB |
- | 2-bit | 176 – 205 GB |
- | 3-bit | 256 – 290 GB |
- | 4-bit | 305 GB |
- | 8-bit | 315 GB |
Considerazioni pratiche sull'hardware:
- Configurazioni per 1-bit: La versione a 1 bit è progettata per funzionare su sistemi con 128 GB di RAM, come un MacBook di fascia alta, un NVIDIA DGX Spark o un RTX Spark. Esiste persino un progetto che dimostra l'esecuzione su un Mac mini M1 con soli 16 GB di memoria unificata, sebbene con prestazioni molto ridotte.
- Configurazioni per 4-bit e 8-bit: Per un servizio realistico con quantizzazione a 4 bit, sono necessarie da 4 a 8 GPU di classe 80 GB (come le A100). Un'alternativa è una workstation con almeno 512 GB di RAM di sistema e una o due GPU, che può tenere i pesi in RAM e trasferire dinamicamente gli "strati esperti" sulla GPU quando servono.
🧠 Eseguirlo senza VRAM, usando solo la RAM?
Sì, è assolutamente possibile, ed è anzi una delle caratteristiche chiave del design di DeepSeek V4.1 Flash. Il modello è pensato per poter essere eseguito su CPU, affidandosi alla RAM di sistema e persino allo streaming da SSD.
- Esecuzione su CPU: Esistono implementazioni (come
colibri) che permettono di eseguire il modello completo (510 GB su disco) su una macchina con sola CPU, leggendo i pesi degli "esperti" direttamente dall'SSD. - Ruolo delle tabelle Engram: Una parte consistente del modello (le tabelle "Engram") può essere tenuta sull'SSD e caricata su richiesta nella cache del sistema operativo, risparmiando preziosa RAM. In alternativa, può essere forzata a rimanere sulla CPU.
- Prestazioni: È importante essere consapevoli del compromesso. L'esecuzione su CPU è molto più lenta rispetto all'uso di una GPU. I dati misurati mostrano velocità nell'ordine di 1 token al secondo (o meno) su configurazioni CPU-only. Quindi, è una soluzione perfettamente funzionante per test, sviluppo o uso personale senza fretta, ma non per un servizio che richiede tempi di risposta rapidi.
💎 Riepilogo
La scelta della quantizzazione per DeepSeek V4.1 Flash è un esercizio di bilanciamento:
- 8-bit offre qualità quasi originale ma richiede un investimento hardware importante (oltre 300 GB di memoria e, realisticamente, una o più GPU).
- 1-bit sacrifica parte della finezza del modello ma lo rende accessibile su hardware consumer (128 GB di RAM), permettendone l'esecuzione anche su CPU e con supporto SSD.
Se il tuo obiettivo è la massima qualità e hai le risorse, punta in alto. Se invece vuoi sperimentare, sviluppare o eseguire il modello in locale su una macchina potente ma non estrema, la quantizzazione a 1 o 2 bit è la strada maestra.